Как выбрать LLM-шлюз: критерии, а не бренды
9 октября 2026
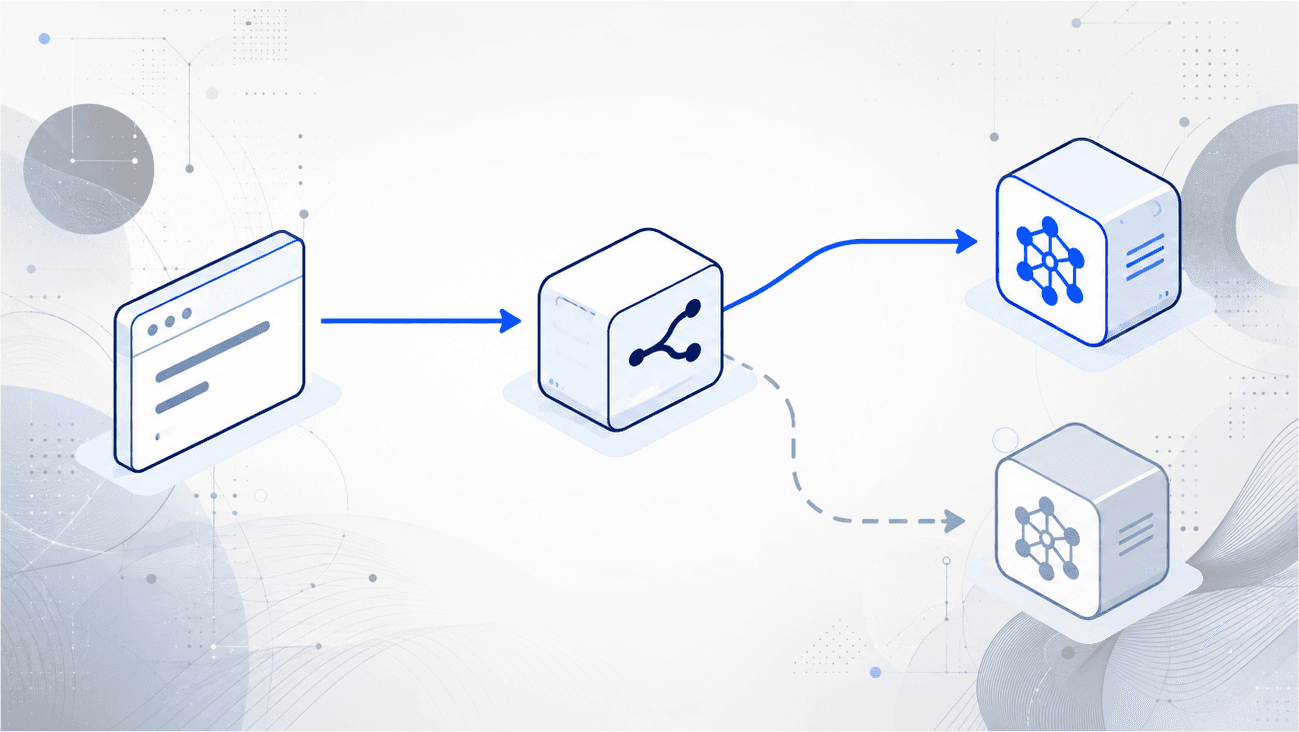
Технически любой шлюз к GPT и Claude это прокси. Такой шлюз принимает твой запрос и пересылает его модели. Поэтому выбирать стоит не по названию, а по тому, на что можно опереться в проде: документы, прозрачная цена, стабильность, судьба данных и запасной вариант.
Под первым роликом серии про автоматизацию самый длинный спор был не про код, а как раз про то, чем шлюз отличается от прокси с наценкой и откуда у российской компании доступ к OpenAI. В этой статье написал критерии, по которым выбираю сам, вопросы, которые стоит задать провайдеру до оплаты, и код, который переживёт смену провайдера.
Сразу о связи с Dockhost: у нас на нём прод и за всё время сотрудничества я ни разу не пожалел об этом. Поэтому альтернативы назову по именам, а критерии подходят для проверки любого провайдера, включая его.
Откуда у шлюза доступ к GPT и Claude
OpenAI и Anthropic не работают с российскими компаниями напрямую, поэтому любой шлюз получает доступ через цепочку: зарубежное юрлицо, партнёрский аккаунт или другой агрегатор. Технически все они делают одно и то же, а отличаются тем, что стоит за пересылкой: договор и документы, наценка, стабильность, поддержка.
Цепочку может оборвать любое звено. С 11 мая 2026 года OpenRouter не поддерживает использование и оплату из России (vc.ru), и все, кто работал через него, искали замену. Поэтому главный вопрос к шлюзу не "самый ли он дешёвый", а "что станет с моим продом, если он завтра отвалится".
Три класса вариантов
Из России к LLM ведут три дороги, и у каждой своя цена.
| Класс | Примеры | Модели | Сильная сторона | О чём помнить |
|---|---|---|---|---|
| Российские и открытые модели в российских облаках | Yandex AI Studio, GigaChat | Alice AI, YandexGPT, GigaChat; в Yandex AI Studio ещё DeepSeek, Qwen и gpt-oss | Данные не уходят за рубеж, договор с крупной компанией; у Yandex AI Studio OpenAI-совместимый API | GPT и Claude здесь нет; качество проверяй на своей задаче |
| Агрегаторы зарубежных моделей | ProxyAPI, AITunnel, VseGPT, BotHub, Polza AI и ещё около десятка сервисов (обзор vc.ru) | GPT, Claude, Gemini, DeepSeek и сотни других | Широкий выбор моделей, оплата в рублях | Наценка от почти нуля до 4X; документы для юрлица есть не у всех; если сервис закроется, предоплаченный баланс можно потерять |
| Инференс у облачного или хостинг-провайдера | Dockhost AI Inference, Timeweb Cloud | GPT, Claude и открытые модели, набор у каждого свой | Один договор, одна поддержка и одни документы на всю инфраструктуру | Всё у одного поставщика, поэтому код держи переносимым |
Если нужны именно GPT или Claude, ты выбираешь между вторым и третьим классом. Если есть требование чтобы данные не покидали Россию, начинай с первого.
Восемь критериев
Цена это лишь один из восьми пунктов, и далеко не всегда главный. Каждый пункт можно проверить самому за час-два, до того как поставить шлюз в прод.
| Критерий | Почему важно | Как проверить |
|---|---|---|
| Юрлицо, договор, закрывающие документы | Компании нужно провести расходы, договор это хотя бы какие-то обязательства сервиса | Можно ли платить по счёту и получать акты; кто именно сторона договора |
| Реальная наценка | Процент в рекламе и фактическая цена часто расходятся | Раздели цену шлюза в рублях за 1 млн токенов на официальную цену модели в долларах и сравни полученный курс с курсом ЦБ (метод из обзора vc.ru) |
| Прозрачный расход токенов | Без него не посчитать стоимость вызова и не заметить код, который сжигает бюджет | В ответе API есть поле `usage`; расход в кабинете сходится с твоими логами и разбит по ключам |
| Та ли это модель | Серый прокси может подменить дорогую модель дешёвой | Поле model в ответе и несколько своих тестовых запросов, ответы на которые ты уже знаешь |
| OpenAI-совместимость | При смене поставщика ты меняешь только адрес и ключ, а не переписываешь код | Твой код на официальном SDK OpenAI работает без правок; если нужны стриминг, вызов инструментов или JSON-режим, проверь и их |
| Стабильность под нагрузкой | В проде ломаются не одиночные запросы, а длинные генерации и лимиты | Прогони 100–200 запросов и пару длинных генераций со стримингом: доля ошибок, задержка, лимит запросов в минуту |
| Данные | Всё, что ты отправил в промпте, проходит через шлюз и вендора модели | Где обрабатывается запрос, сохраняются ли промпты и как долго, идут ли они на обучение |
| Поддержка и SLA | Когда прод лежит ночью, важнее всего, ответит ли кто-то | Задай технический вопрос до оплаты и засеки время; посмотри, есть ли SLA в договоре |
Отдельно про персональные данные. Если в запросах есть имена, телефоны или почта клиентов, а модель зарубежная, это трансграничная передача: до её начала компания обязана уведомить Роскомнадзор, и поправки от 26 июля 2026 года это требование сохранили (разбор изменений, передача данных в AI-сервисы). Российский шлюз посередине не делает передачу внутренней: данные всё равно уходят к зарубежной модели. Проще всего обезличивать данные до запроса или брать для таких задач модели в российском облаке. Если в твоей задаче этот вопрос поднялся, то лучше обсуди его с юристом.
Письмо в поддержку до оплаты
Одно письмо на почту / в телеграмм чат поддержки закрывает половину критериев и заодно проверяет саму поддержку: сколько ждать ответа и отвечает ли человек по существу. Копируй и отправляй всем кандидатам сразу.
Здравствуйте! Выбираем провайдера LLM API для продакшена. Подскажите, пожалуйста:

1. Работаете ли вы с юрлицами по договору, с оплатой по счёту и закрывающими документами?
2. Какая цена за 1 млн входных и выходных токенов у моделей [список]? Есть ли минимальный платёж, сгорает ли неиспользованный баланс?
3. Где обрабатываются запросы? Сохраняете ли вы промпты и ответы, и если да, то на какой срок?
4. Какие лимиты запросов в минуту на один ключ и можно ли их поднять?
5. Поддерживаются ли стриминг, вызов инструментов и JSON-режим через OpenAI-совместимый API?
6. Есть ли SLA и страница статуса? Как с вами связаться, если в два часа ночи всё упало?
Таким способом ты одновременно проверишь и уровень лояльности поддержки провайдера к клиентам. Если тебя отправят смотреть запрошенную информацию на сайт, то делай соответствующие выводы.
Код, который переживёт смену провайдера
Лучшая страховка от любого шлюза это код, в котором провайдер отражается в трех переменных окружения: адрес, ключ и имя модели. Имя модели тоже выносим, т.к. у разных провайдеров одна и та же модель часто называется по-разному.
# .env
LLM_BASE_URL=https://<адрес основного провайдера>/v1
LLM_API_KEY=<ключ>
LLM_MODEL=<имя модели у основного провайдера>

LLM_FALLBACK_BASE_URL=https://<адрес запасного провайдера>/v1
LLM_FALLBACK_API_KEY=<ключ>
LLM_FALLBACK_MODEL=<имя модели у запасного провайдера>
import os

import openai
from openai import OpenAI

# Основной и запасной провайдер: адрес, ключ и модель — только в переменных окружения
PROVIDERS = [
    (
        "основной",
        OpenAI(base_url=os.environ["LLM_BASE_URL"], api_key=os.environ["LLM_API_KEY"], timeout=60, max_retries=2),
        os.environ["LLM_MODEL"],
    ),
    (
        "запасной",
        OpenAI(base_url=os.environ["LLM_FALLBACK_BASE_URL"], api_key=os.environ["LLM_FALLBACK_API_KEY"], timeout=60, max_retries=2),
        os.environ["LLM_FALLBACK_MODEL"],
    ),
]


def ask(messages: list[dict]) -> str:
    errors = []
    for name, client, model in PROVIDERS:
        try:
            response = client.chat.completions.create(model=model, messages=messages)
        except openai.APIError as e:  # сеть, таймаут, ответы 4xx и 5xx
            errors.append(f"{name}: {e}")
            continue
        text = response.choices[0].message.content if response.choices else None
        if text:  # бывает, что шлюз отвечает 200, но без текста
            return text
        errors.append(f"{name}: пустой ответ")
    raise RuntimeError("Ни один провайдер не ответил: " + "; ".join(errors))


if __name__ == "__main__":
    print(ask([
        {"role": "system", "content": "Ты технический специалист, отвечай кратко на русском языке."},
        {"role": "user", "content": "Что такое контейнер?"},
    ]))
Если основной провайдер вернул ошибку, не уложился в таймаут или прислал пустой ответ, запрос уйдёт к запасному. Переезд целиком сводится к замене трёх строк в `.env`. Запасной аккаунт стоит пополнить на небольшую сумму заранее: иначе, если авария всё же произойдет, то придется регистрироваться и ждать зачисления платежа.
Почему у нас Dockhost
Прод собственных и части клиентских проектов MEIJI MEDIA живёт на Dockhost, потому что за всё время он ни разу не оставил нас одних с проблемой.
До него мы плотно сидели на Timeweb: когда мы искали контейнерный хостинг, вменяемых альтернатив в России, по нашему опыту, не было. К Dockhost мы подключились на самой ранней стадии их запуска и засыпали их тикетами с пожеланиями, и на каждый получали отклик. Поддержка отвечает днём и ночью и реально помогает. Несколько раз инженеры вручную протаскивали наши конфигурации, которые их оркестратор тогда даже не предусматривал.
С инференсом LLM та же история: у Dockhost у нас не было ни одного отказа доступа. На Timeweb мы тоже пользовались инференсом, и там случалось, что вместо ответа модели приходила ошибка.
Поэтому сейчас у меня нет причин смотреть куда-то ещё. Но код я всё требую держать таким, как выше потому что хорошая работа провайдера сегодня — это причина его выбрать, а не гарантия на завтра.
Когда шлюз не нужен
Шлюз нужен, когда модель вызывает твой код и нужны именно зарубежные модели. В трёх случаях он лишний.
- Работаешь с текстом сам, в чате. Подписка дешевле и удобнее, API-ключ для этого не нужен.
- В запросах персональные данные или коммерческая тайна, и отправлять их за рубеж нельзя. Бери модели в российском облаке: YandexGPT, GigaChat или открытые модели вроде Qwen и DeepSeek в Yandex AI Studio.
- Нагрузка большая и ровная, а данные чувствительные. Стоит посчитать своё развёртывание открытой модели на арендованных GPU. Дороже на старте, зато без посредника и наценки за токены.
Итог
Выбирай шлюз по тому, на что сможешь опереться в проде: документы, реальная наценка, прозрачный расход, стабильность, данные и живая поддержка. Проверь это письмом и нагрузочным тестом до оплаты, а код держи таким, чтобы переезд занимал минуты.
Разборы вопросов из комментариев и другая польза — в моём Telegram-канале.